Kapitel 5: Rekursion
Eine Methode (mit oder ohne Rückgabewert, mit oder ohne Parameter) darf in der Deklaration ihres Rumpfes den eigenen Namen verwenden. Hierdurch kommt es zu einem rekursiven Aufruf, einem Aufruf von sich selbst. Typischerweise werden dabei die aktuellen Parameter so modifiziert, dass die Problemgröße schrumpft, damit nach mehrmaligem Wiederholen dieses Prinzips schließlich kein weiterer Aufruf erforderlich ist und die Rekursion abbrechen kann.
Ein einfaches Rezept für rekursive Methoden
Beim ersten Kontakt mit Rekursion wirkt es oft so, als würde sich eine Methode „mysteriös selbst aufrufen". Tatsächlich folgen korrekt aufgebaute rekursive Methoden immer demselben einfachen Grundschema.
Eine rekursive Methode besteht aus drei wesentlichen Bestandteilen:
- Abbruchbedingung (Basisfall, Rekursionsbremse): Ein Fall, der direkt berechnet werden kann und keinen weiteren rekursiven Aufruf erfordert.
- Rekursionsschritt: Das ursprüngliche Problem wird auf ein kleineres oder einfacheres Teilproblem zurückgeführt.
- Fortschritt: Bei jedem rekursiven Aufruf muss sichergestellt sein, dass das Teilproblem dem Basisfall näher kommt.
Eine hilfreiche Denkweise ist dabei die Folgende:
Man muss nicht verstehen, wie viele rekursive Aufrufe insgesamt stattfinden. Es genügt, den nächsten Schritt korrekt zu formulieren und darauf zu vertrauen, dass die Methode für das kleinere Teilproblem nach denselben Regeln arbeitet.
Im Folgenden sehen wir uns Beispiele an, die wir sowohl iterativ, mit Hilfe wiederholter Schleifendurchläufe, als auch mithilfe von Rekursion implementieren.
Fakultät
Aus der Schule kennen Sie für die Definition und Berechnung der Fakultät einer Zahl $x$ vermutlich die folgende Formel:
$$ x! = \left\{ \begin{array}{lcl} 1 & , & x = 0 \\ 1 \cdot 2 \cdot{} \dots{} \cdot x & , & x \in \mathbb{N}: x > 0 \\ \end{array} \right. $$Diese Formel würden Sie als Java-Programm, mit den bisher erworbenen Kenntnissen, wohl wie folgt umsetzen:
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Iterative Fakultätsberechnung.
 6 */
 7public class FacultyIterative {
 8    // Berechnung der Fakultät von n mittels einer Schleife.
 9    private static long faculty(int x) {
10        long f = 1;
11
12        // berechne: f = x! = 1 * ... * x
13        for (int i = 1; i <= x; i++)
14            f = f * i;
15
16        return f;
17    }
18
19    /**
20     * Berechnung der Fakultät einer interaktiv einzulesenden
21     * ganzen Zahl.
22     *
23     * @param args nicht genutzt
24     */
25    public static void main(String[] args) {
26        int x = StdIn.readlnInt("Ganze Zahl [0, 20]: ");
27        StdOut.println(faculty(x));
28    }
29}
Listing 5.1: FacultyIterative.java
Hinweis: Auf eine Fehlerbehandlung wird explizit verzichtet, um nicht vom Wesentlichen abzulenken! - Das werde ich weitestgehend auch im Folgenden so halten.
Wenn Sie an der Hochschule studieren (oder studiert haben), sind sie vermutlich mit dieser Definition der Fakultät vertraut:
$$ x! = \left\{ \begin{array}{lcl} 1 & , & x = 0 \\ x \cdot (x-1)! & , & x \in \mathbb{N}: x > 0 \\ \end{array} \right. $$Diese Formel nutzt Rekursion. Wollen wir beispielsweise $5!$ berechnen, sagt uns die Formel, dass das $5\cdot(5-1)!$, also $5\cdot4!$, ist. Wissen wir nicht, was $4!$ ist, wenden wir hierfür die Formel erneut an. Nach endlich langer Zeit gelangen wir zur Fakultät von $0$, deren Wert direkt ablesbar ist. Das ist dann auch die sogenannte Rekursionsbremse, der Basisfall. Wir brauchen die Formel nicht nochmals anwenden. Wir haben jetzt alle benötigten Werte. - In jedem Rekursionsschritt wurde das Problem um eins kleiner.
$$ \begin{array}{lcl} 5! & = & 5 \cdot 4! \\ & = & 5 \cdot 4 \cdot 3! \\ & = & 5 \cdot 4 \cdot 3 \cdot 2! \\ & = & 5 \cdot 4 \cdot 3 \cdot 2 \cdot 1! \\ & = & 5 \cdot 4 \cdot 3 \cdot 2 \cdot 1! \\ & = & 5 \cdot 4 \cdot 3 \cdot 2 \cdot 1 \cdot 1 = 120 \end{array} $$Anhand der Formel sehen Sie schon, dass Rekursion vom Ansatz her keine clevere Programmierung, im Sinne eines Hacks, ist, sondern im Wesentlichen eine induktive Definition. Die können wir uns bei der Implementierung zu Nutze machen. Die obige Rekursionsformel ist in Java quasi 1:1 umsetzbar.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Rekursive Fakultätsberechnung.
 6 */
 7public class FacultyRecursive {
 8
 9    // Berechnung der Fakultät von n mittels rekursiver Aufrufe
10    // von faculty().
11    private static long faculty(int x) {
12        if (x == 0)  // Rekursionsbremse
13            return 1;
14        else
15            return x * faculty(x-1);
16    }
17
18    /**
19     * Berechnung der Fakultät einer interaktiv einzulesenden
20     * ganzen Zahl.
21     *
22     * @param args nicht genutzt
23     */
24    public static void main(String[] args) {
25        int x = StdIn.readlnInt("Ganze Zahl [0, 20]: ");
26
27        StdOut.println(faculty(x));
28    }
29}
Listing 5.2: FacultyRecursive.java
Wir begrenzen x wieder lediglich durch einen Hinweis in der Eingabeaufforderung. Für die Korrektheit des Programms ist dieser Hinweis jedoch extrem wichtig, weil es bei einem größeren Wert als $20$ zu einem Überlauf des Datentyps long kommt.
Wenn Sie Computer spielen, das Programm manuell nachvollziehen, stellen Sie fest, beim ersten Aufruf von faculty() mit einem Wert größer als $0$ (beispielsweise $5$), den rekursiven Aufruf in Zeile 15 ausführen zu müssen. Das ist die Entsprechung von oben: „Wissen wir nicht, was $4!$ ist, wenden wir hierfür die Formel erneut an." Und ebenso wie oben, wo sich meine handschriftliche Berechnung Zeile für Zeile erweitert hat, so funktioniert das auch hier. Handschriftlich habe ich mir die $5$, die $4$ usw. gemerkt. Ausrechnen konnte ich meine gemerkten Zwischenschritte erst nachdem ich die $1$ erhalten habe. Genau das ist auch die Art und Weise, wie Java (und jede andere Programmiersprache) arbeitet, wenn Sie Rekursionen ausführt.
Java merkt sich intern den aktuellen Status der rekursiven Aufrufe. Nur verwendet Java nicht Papier und Bleistift, sondern einen sogenannten Aufrufstack. Sie können ihn sich als einen Stapel von Methodenaufrufen vorstellen, bei dem sich Java für jeden Aufruf die aktuell bereits evaluierten Variablenwerte merkt. Sobald dann im letzten Rekursionsschritt alle konkreten Ergebnisse vorliegen, wird der Stapel schichtweise wieder abgetragen. Ist das geschehen, steht das Ergebnis der Berechnung fest und wird an den Aufrufer zurückgegeben.
Schauen wir uns an, welchen Aufwand beide Programme betreiben müssen, um ihre Berechnungen auszuführen. Die iterative Fakultätsberechnung benötigt für eine Eingabe der Größe $n$ genau einen Methodenaufruf und $n-1$ Multiplikationen, die innerhalb der Methode ausgeführt werden. Die Rekursionslösung benötigt dafür $n$ Methodenaufrufe. Davon sind $n-1$ rekursiv. Die Anzahl der letztlich durchzuführenden Multiplikationen beträgt ebenfalls $n-1$.
In beiden Fällen ist der Aufwand direkt und linear abhängig von der Eingabegröße. Im Falle der Rekursion haben wir, rein technisch betrachtet, den zusätzlichen Aufwand für die Verwaltung der Methodenaufrufe.
Wir halten fest:
- Rekursion funktioniert wie eine Art „Protokoll", in welchem die Zwischenergebnisse festgehalten werden.
- Jede Rekursion benötigt zwingend eine Rekursionsbremse. Andernfalls erzeugen Sie eine endlose Rekursion. Im Gegensatz zu einer Endlosschleife läuft eine Rekursion aber dennoch nicht endlos. Das „Protokoll" ist hinsichtlich seiner Aufzeichnungskapazität begrenzt. Ist diese erschöpft, bricht das Programm mit einem Fehler ab.
Größter gemeinsamer Teiler (ggT)
Wir betrachten ausschließlich natürliche Zahlen größer als $0$. Umgangssprachlich ist dann der größte gemeinsame Teiler zweier Zahlen die größte aller Zahlen, die beide Zahlen ohne Rest teilt.
$$ \text{ggT}(x, y) = \text{ größter gemeinsamer Teiler von } x \text{ und } y. $$Jeder kennt das Problem aus der Schule. Es wird probiert. Mit der kleinsten der beiden Zahlen beginnend, wird ausprobiert, ob diese Zahl die Zahlen $x$ und $y$ teilt. Hat man Pech, probiert man bis zur $1$. Dieses Vorgehen nennen wir „gewaltsames Vorgehen". Es steckt nicht viel Geist darin, auf diese Weise den ggT zweier Zahlen zu finden.
Euklid, ein griechischer Mathematiker der Antike, erkannte jedoch folgenden Zusammenhang:
Sei $t$ ein gemeinsamer Teiler von $x$ und $y$. Dann ist
$$ x = t \cdot a \land{} y = t \cdot b \text{ mit } a, b, t \in \mathbb{N}^{-0} \\ $$Bilden wir die Differenz von $x$ und $y$ gilt offenbar:
$$ x - y = t \cdot (a - b) $$Das heißt nichts anderes, als das $t$ auch die Differenz von $x$ und $y$ teilt. Das Problem lässt sich also durch die Bildung der Differenz verkleinern, ohne das Problem als solches zu verändern.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Bestimmung des größten gemeinsamen Teilers zweier positiver
 6 * Ganzzahlen.
 7 */
 8public class GCD {
 9    // Iterative Berechnung des ggT nach Euklid.
10    private static int gcd(int a, int b) {
11        while (a != b) {
12            if (a > b) a = a - b;
13            else       b = b - a;
14        }
15        return a;
16    }
17
18    /**
19     * Es werden zwei positive Ganzzahlen eingelesen und deren
20     * größter gemeinsamer Teiler bestimmt.
21     *
22     * @param args nicht genutzt
23     */
24    public static void main(String[] args) {
25        int x = StdIn.readlnInt("x: ");
26        int y = StdIn.readlnInt("y: ");
27
28        StdOut.printf("ggT(%d, %d) = %d\n", x, y, gcd(x, y));
29    }
30}
Listing 5.3: GCD.java
Es wird wiederholt die kleinere von der größeren Zahl abgezogen, bis beide gleich sind. Das ist dann der größte gemeinsame Teiler.
Beispielsitzung:
$ java GCD
x: 1348763
y: 52
ggT(1348763, 52) = 13
$ _
Ich habe das Programm für die Ausgabe modifiziert und die Anzahl der Iterationen in der while-Schleife gezählt. Das Beispiel hat $25,940$ Wiederholungen benötigt. Für den Computer ist das kein Problem. Für uns Menschen ist es faktisch unmöglich mit solchen Zahlen den ggT zu bestimmen. Je größer die Differenz, umso geringer ist pro Schritt die Verkleinerung des Problems. Das Programm hat $25,938$ Male durch $52$ dividiert. - Modifizieren Sie Ihr Programm und probieren es selbst aus!
Überlegen wir, wie wir die Anzahl der erforderlichen Iterationen verringern können. Die Idee lautet wie folgt: Wiederholte Differenzenbildung ist nichts anderes als einmal Modulo zu rechnen.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Bestimmung des größten gemeinsamen Teilers zweier positiver
 6 * Ganzzahlen (optimiert).
 7 */
 8public class GCDTurbo {
 9    // Optimierte iterative Berechnung des ggT nach Euklid.
10    private static int gcd(int a, int b) {
11        while (b != 0) {
12            int hlp = a % b;
13            a = b;
14            b = hlp;
15        }
16        return a;
17    }
18
19    /**
20     * Es werden zwei positive Ganzzahlen eingelesen und deren
21     * größter gemeinsamer Teiler bestimmt.
22     *
23     * @param args nicht genutzt
24     */
25    public static void main(String[] args) {
26        int x = StdIn.readlnInt("x: ");
27        int y = StdIn.readlnInt("y: ");
28
29        StdOut.printf("ggT(%d, %d) = %d\n", x, y, gcd(x, y));
30    }
31}
Listing 5.4: GCDTurbo.java
Dieser Algorithmus benötigt nur noch $3$ Iterationen für das gezeigte Zahlenbeispiel! - Eine enorme Verbesserung.
Die Modulo-Operation verkleinert das Problem in einem Schritt grundsätzlich um deutlich mehr als es eine einfache Differenzenbildung schafft. Insgesamt ist die Anzahl der notwendigen Iterationen stark von der Konstellation der Zahlen $x$ und $y$ abhängig.
Eine rekursive Implementierung greift die Idee des letzten Algorithmus quasi 1:1 auf.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Bestimmung des größten gemeinsamen Teilers zweier positiver
 6 * Ganzzahlen (optimiert, rekursiv).
 7 */
 8public class GCDRecursive {
 9    // Optimierte rekursive Berechnung des ggT nach Euklid.
10    static int gcd(int a, int b) {
11        if (b == 0) return a;  // Rekursionsbremse
12        else        return gcd(b, a % b);
13    }
14
15    /**
16     * Es werden zwei positive Ganzzahlen eingelesen und deren
17     * größter gemeinsamer Teiler bestimmt.
18     *
19     * @param args nicht genutzt
20     */
21    public static void main(String[] args) {
22        int x = StdIn.readlnInt("x: ");
23        int y = StdIn.readlnInt("y: ");
24
25        StdOut.printf("ggT(%d, %d) = %d\n", x, y, gcd(x, y));
26    }
27}
Listing 5.5: GCDRecursive.java
Insbesondere stimmen Schleifenbedingung und Rekursionsbremse in ihrer jeweiligen Aussage überein. Die Verarbeitung wird beendet, wenn die zweite Zahl (b) auf den Wert $0$ transformiert wurde, also kein Rest bei der Restwertdivision übrig bleibt.
Im Vergleich Rekursions- und Iterationslösung stimmen Anzahl der Rekursionsaufrufe und Anzahl der Iterationen überein.
Fibonacci
Die Fibonacci-Folge ist eine unendliche Folge natürlicher Zahlen. Sie beginnt mit zwei Einsen. Jede weitere Zahl ist die Summe der beiden vorangegangenen Zahlen.
Tabelle 5.1: Fibonacci-Folge
| $x$ | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | … |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $f(x)$ | 1 | 1 | 2 | 3 | 5 | 8 | 13 | 21 | 34 | 55 | 89 | … |
Zur Berechnung der $x$-ten Fibonacci-Zahl haben wir die folgenden Formel anzuwenden:
$$ f(x) = \left\{ \begin{array}{lcl} 1 & , & x \in \{0, 1\} \\ f(x-1) + f(x-2) & , & x \in \mathbb{N}: x > 1 \\ \end{array} \right. $$Aus der Formel eine iterative Lösung ableiten zu wollen, ist schwierig. Deutlich einfacher ist es, sich an der textuellen Beschreibung zu orientieren. Anhand der Kommentare im Code sind die Rechenschritte ersichtlich.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Iterative Implementierung einer Fibonacci-Folge.
 6 */
 7public class FibonacciIterative {
 8    // Fibonacci-Zahl zu x berechnen (iterativ).
 9    private static long fibonacci(int x) {
10        if (x <= 1) return 1;
11
12        long a = 1, b = 1;
13        for (int i = 2; i <= x; i++) {
14            long temp = a + b;  // aktuelle Summe merken
15            a = b;              // Vorvorgänger wird Vorgänger
16            b = temp;           // aktuelle Summe
17        }
18        return b;
19
20    }
21
22    /**
23     * Für eine einzulesende nicht-negative Ganzzahl wird die
24     * korrespondierende Fibonacci-Zahl berechnet.
25     *
26     * @param args nicht genutzt
27     */
28    public static void main(String[] args) {
29        int x = StdIn.readlnInt("Ganze Zahl [0, 91]: ");
30        StdOut.println(fibonacci(x));
31    }
32}
Listing 5.6: FibonacciIterative.java
Analog zur Fakultät begrenzen wir die Eingabegröße durch einen bloßen Hinweis, um einen Überlauf zu vermeiden.
Der Versuch, die $x$-te Fibonacci-Zahl rekursiv zu ermitteln, bereitet uns weniger Kopfzerbrechen. Wie schon bei der Fakultät können wir die Formel direkt in Java-Code umsetzen.
 1import de.pakad.stdtools.StdIn;
 2import de.pakad.stdtools.StdOut;
 3
 4/**
 5 * Rekursive Implementierung einer Fibonacci-Folge.
 6 */
 7public class FibonacciRecursive {
 8    // Fibonacci-Zahl zu x berechnen (rekursiv).
 9    private static long fibonacci(int x) {
10        if (x <= 1)
11            return 1;  // Rekursionsbremse
12        else
13            return fibonacci(x-1) + fibonacci(x-2);
14
15    }
16
17    /**
18     * Für eine einzulesende nicht-negative Ganzzahl wird die
19     * korrespondierende Fibonacci-Zahl berechnet.
20     *
21     * @param args nicht genutzt
22     */
23    public static void main(String[] args) {
24        int x = StdIn.readlnInt("Ganze Zahl [0, 91]: ");
25        StdOut.println(fibonacci(x));
26    }
27}
Listing 5.7: FibonacciRecursive.java
Betrachten wir den jeweiligen Aufwand der zwei Algorithmen. Die iterative Lösung benötigt, um die $n$-te Fibonacci-Zahl zu berechnen, $n$ Schritte.
Den Aufwand der rekursiven Berechnung zu bestimmen, erfordert ein wenig Mathematik und ist anspruchsvoller.
Vereinfachend überlegen wir uns das Folgende:
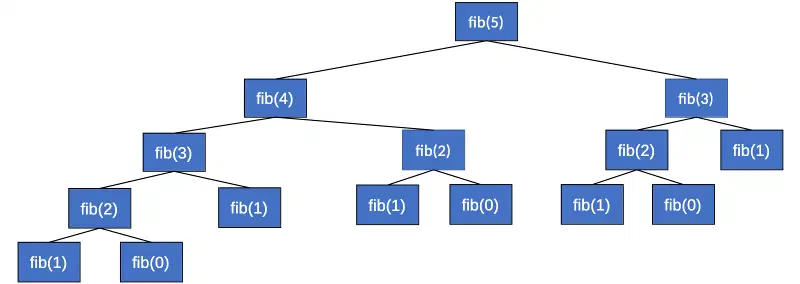
Der Aufruf fibonacci(x-1) + fibonacci(x-2) stößt ganz offenbar eine Mehrfachberechnung an. Die Anzahl der Aufrufe wächst dadurch deutlich schneller als das wir uns dem Ziel nähern. Die Methodennamen sind hier aus Darstellungsgründen mit fib abgekürzt.
fibonacci(5)
Sei das aktuell betrachtete $x$ die Zahl $5$. Dann ist $x-2$ die $3$. Deren Funktionswert hat der Algorithmus aber schon einmal berechnet. Er hat aber kein „Gedächtnis", kann nicht auf bereits berechnete Werte zurückgreifen. Besonders klar wird dieser Sachverhalt, wenn wir ihn uns als einen Baum der Methodenaufrufe, wie oben gezeigt, visualisieren. Im nächsten Kapitel werden wir die Laufzeit des rekursiven Fibonacci-Algorithmus, wie wir ihn implementiert haben, berechnen.
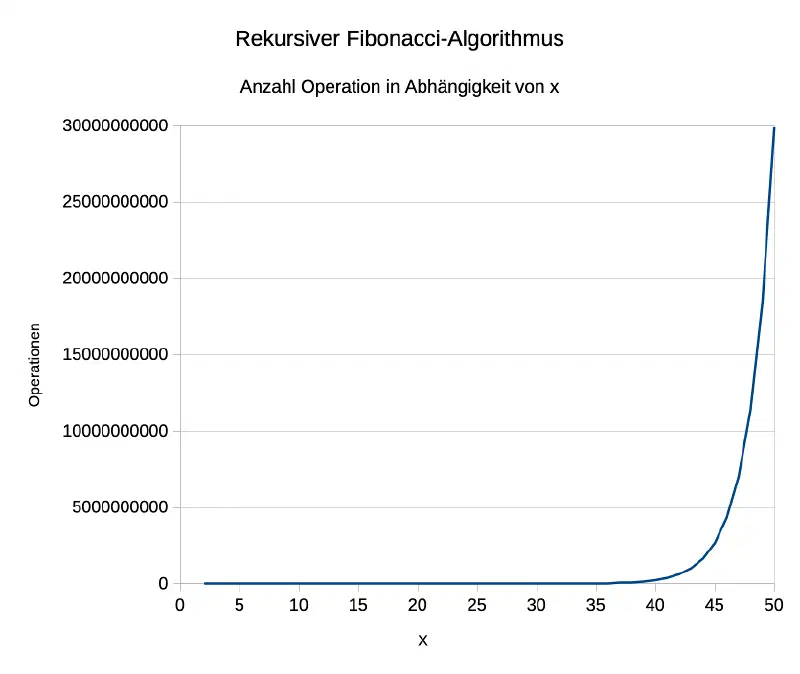
Warnung: Versuchen Sie nicht, unsere Implementierung beispielsweise mit einer Eingabe von 91 zu quälen. Sie werden das Ergebnis im Laufe Ihrer Lebenszeit nicht zu Gesicht bekommen. Approximativ berechnet, würde mein M3 Max-Prozessor knapp mehr als $2,800$ Jahre dafür benötigen. Der schafft ca. $65.5$ TeraFlops (Billionen Operationen pro Sekunde) bei ganzzahligen Operationen. Der Algorithmus erfordert jedoch bei dieser Eingabe etwa $11,637,677,644,705,086,096$ Operationen. - Lassen Sie es also bleiben!
Der Klassiker: Türme von Hanoi
Die Türme von Hanoi sind in der Informatik der Klassiker in Bezug auf Rekursion. Ihre iterative Implementierung ist extrem schwierig. Die Rekursionslösung ist dagegen geradezu einfach. Vor allem ist sie auch noch kurz und elegant zu implementieren.
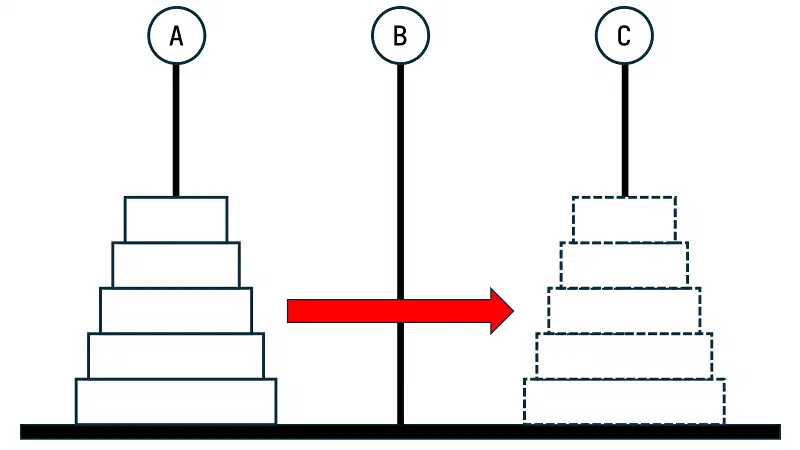
Die Türme von Hanoi sind ein Spiel mit den folgenden Regeln:
Das Spiel wird von einer Person gespielt. Es besteht aus drei gleich großen Stäben, auf die mehrere gelochte Scheiben gesteckt werden, alle verschieden groß.
Zu Beginn liegen alle Scheiben auf dem linken Stab, der Größe nach geordnet, mit der größten Scheibe unten und der kleinsten oben.
Ziel des Spiels ist es, den kompletten Scheiben-Stapel vom linken Stab auf den rechten Stab zu versetzen. Hierbei gelten zwei Regeln:
- Es darf immer nur eine Scheibe auf einmal bewegt werden.
- Die bewegte Scheibe darf nicht auf eine kleinere Scheibe gesteckt werden.
Folglich sind zu jedem Zeitpunkt des Spieles die Scheiben auf jedem Stab der Größe nach geordnet.
Spielen wir die ersten Fälle einmal durch.
Scheibenanzahl: 1
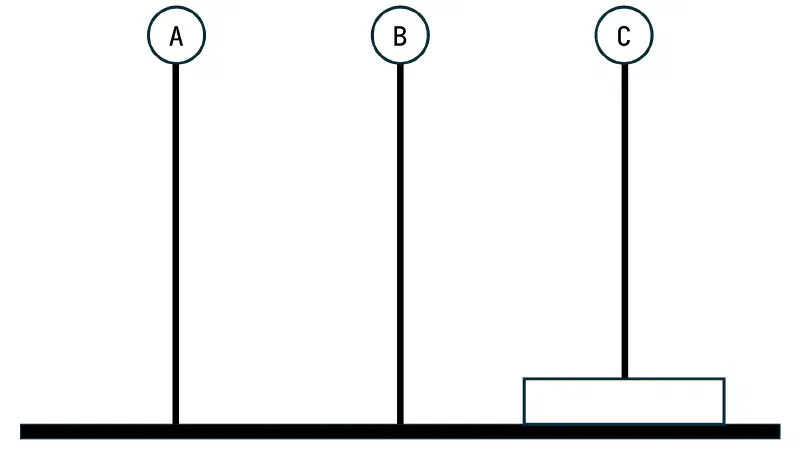
Es gilt eine einzige Scheibe von A nach C zu transportieren. Das ist trivial.
Nimm die Scheibe von A und lege sie nach C.
Scheibenanzahl: 2
Visualisieren wir uns den Fall:
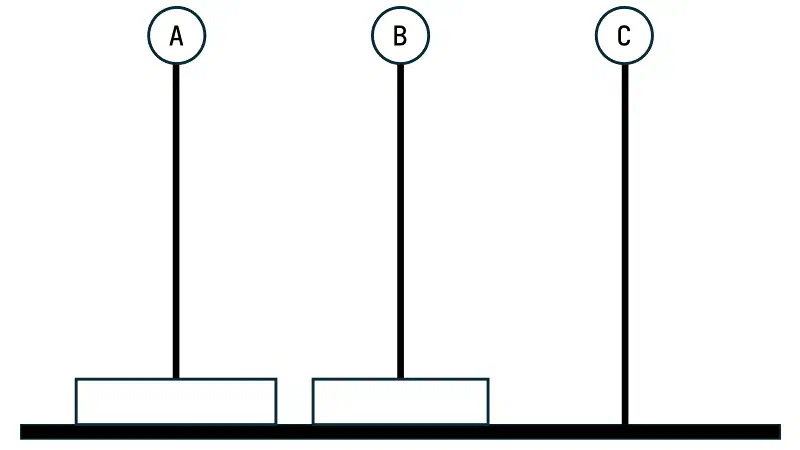
Um zwei Scheiben von A nach C zu transportieren, nutzen wir B als Zwischenspeicher für die oben liegende Scheibe des Stapels A. Nun liegt die unterste Scheibe frei. Sie kann direkt, siehe voriger Fall, nach C transportiert werden. Für die Scheibe auf dem Zwischenspeicher gilt selbiges. Sie kann direkt nach C transportiert werden.
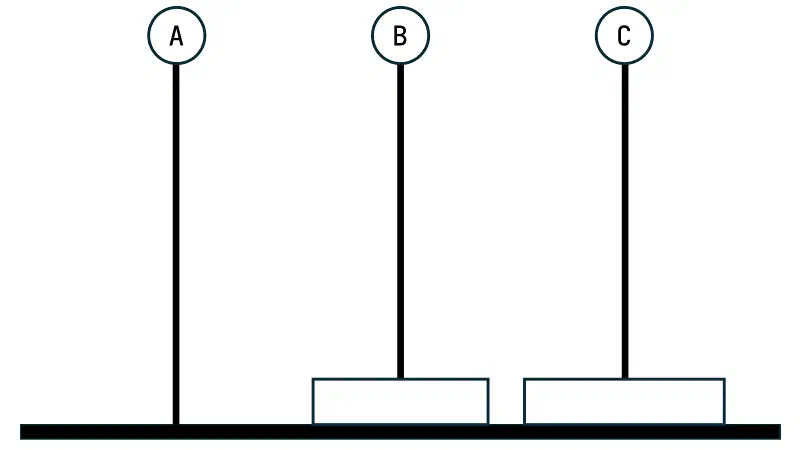
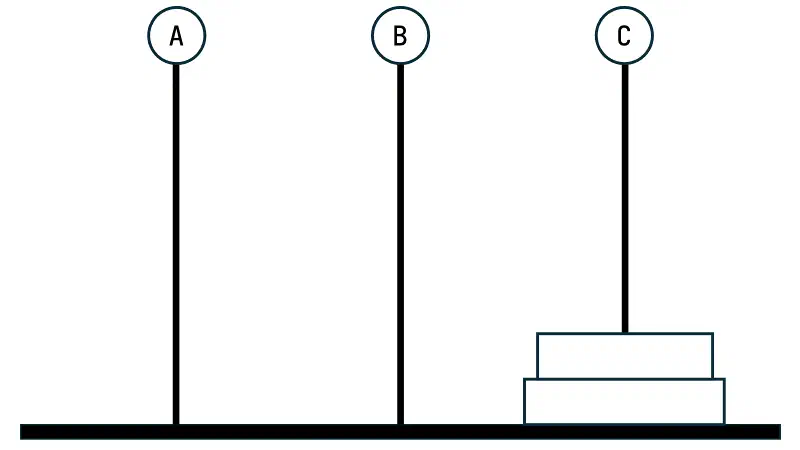
Achtung: In Abbildung 5.3 haben wir, nach dem Verlegen der Scheibe von A nach C, eine Situation, die der Aufgabenstellung, nur eine Scheibe zu bewegen, ganz ähnlich ist. Wir haben in der Tat insoweit eine identische Aufgabenstellung, als das wirklich nur noch eine Scheibe bewegt werden muss. Im Gegensatz zum Ein-Scheiben-Fall aus dem vorigen Beispiel liegt diese Scheibe aber auf B, nicht auf A. Dennoch ist die Bewegung die gleiche, wenn wir die umgangssprachliche Formulierung etwas anpassen: Bewege die Scheibe von ihrem Quell- zum Zielstapel.
Was mit zwei Scheiben funktioniert, funktioniert nach dem gleichen Prinzip auch mit drei und mehr Scheiben.
Scheibenanzahl: 3
Ich beschreibe hier nur die Scheibenbewegungen:
- Scheibe von A nach C
- Scheibe von A nach B
- Scheibe von C nach B
- Scheibe von A nach C
- Scheibe von B nach A
- Scheibe von B nach C
- Scheibe von A nach C
Wenn wir $n$ Scheiben von A nach C transportieren wollen, müssen wir $n-1$ Scheiben auf dem Zwischenspeicher zwischenlagern, um dann die noch verbliebene Scheibe des Quellstapels direkt auf den Zielstapel legen zu können. Danach haben wir die $n-1$ Scheiben, die auf dem Zwischenstapel liegen, ebenfalls zum Zielstapel zu transportieren. Dabei bildet der ehemalige Zwischenstapel den aktuellen Quellstapel und der ehemalige Quellstapel des ursprünglichen Turms dient als Zwischenstapel.
Beachten Sie, bereits in der umgangssprachlichen Formulierung der Lösungsschritte zwei Rekursionen benannt zu haben.
Hat man das Prinzip begriffen, kann man das Spiel direkt in einem Programm Hanoi.java codieren, welches die Bewegungen für $n$ Scheiben ausgibt.
 1import de.pakad.stdtools.StdOut;
 2
 3/**
 4 * Türme von Hanoi.
 5 *
 6 * Die Anzahl der zu bewegenden Scheiben wird als Kommandozeilenargument
 7 * eingelesen.
 8 */
 9public class Hanoi {
10
11    // rekursive Scheibenbewegungen
12    private static void move(int n, char src, char temp, char target) {
13        if (n > 0) { // Basisfall n == 0 -> nichts tun
14            move(n-1, src, target, temp); // Fortschritt n-1
15            StdOut.printf("Scheibe %d von %c nach %c\n", n, src, target);
16            move(n-1, temp, src, target); // Fortschritt n-1
17        }
18    }
19
20    /**
21     * Die Anzahl der zu bewegenden Scheiben wird als
22     * Kommandozeilenargument eingelesen.
23     *
24     * @param args [0] - Scheibenanzahl
25     */
26    public static void main(String[] args) {
27        int discs = Integer.parseInt(args[0]);
28        move(discs, 'A', 'B', 'C');
29    }
30}
Listing 5.8: Hanoi.java
Eine rekursive Implementierung ist geradezu „natürlich". Der Programmcode ist zudem erfreulich kurz. Er setzt 1:1 die Erläuterungen um. Um $n$ Scheiben von A nach C zu bewegen, gehen wir folgt vor:
- Bewege $n-1$ Scheiben vom Quellstapel A auf den Zielstapel B. Nutze C als Zwischenspeicher.
- Bewege $n-1$ Scheiben vom Quellstapel B auf den Zielstapel C. Nutze A als Zwischenspeicher.
$ java Hanoi 4
Scheibe 1 von A nach B
Scheibe 2 von A nach C
Scheibe 1 von B nach C
Scheibe 3 von A nach B
Scheibe 1 von C nach A
Scheibe 2 von C nach B
Scheibe 1 von A nach B
Scheibe 4 von A nach C
Scheibe 1 von B nach C
Scheibe 2 von B nach A
Scheibe 1 von C nach A
Scheibe 3 von B nach C
Scheibe 1 von A nach B
Scheibe 2 von A nach C
Scheibe 1 von B nach C
$ _
Bei $n$ Scheiben sind $2^n-1$ Scheibentransporte auszuführen.
Das Spiel wurde ehedem vom französischen Mathematiker Édouard Lucas ersonnen und hatte acht Scheiben. Er dachte sich dazu die Geschichte aus, dass dies eine vereinfachte Version des Turms von Brahma sei. Indische Mönche im großen Tempel zu Benares, im Mittelpunkt der Welt, mussten einen Turm aus 64 goldenen Scheiben versetzen. Bevor ihnen das gelang, sei der Tempel jedoch zu Staub zerfallen und mit einem Donnerschlag das Ende der Welt gekommen - so die Legende.
Bei acht Scheiben sind bereits 255 Scheibentransporte durchzuführen. 64 Scheiben erfordern $18,446,744,073,709,551,615$ Scheibentransporte. Ob mit oder ohne Donnerschlag, bis das geschafft ist, existiert der Planet Erde wohl nicht mehr.
Schlussbemerkung zu Rekursionen
Wir haben in diesem Kapitel viel gelernt. Wir haben uns unterschiedliche Herangehensweisen an eine Problemlösung angesehen (ggT, Fibonacci), haben Iterationen mit Rekursionen verglichen und dabei ebenfalls festgestellt, dass die Fibonacci-Folge, je nach Herangehensweise, strukturell geradezu explosiv sein kann. Wir haben aber auch gesehen, dass Rekursionen „natürlich" sein können und eine naheliegende und leicht verständliche Lösung darstellen (Fakultät, Hanoi).
Wir können unsere Erfahrungen wie folgt zusammenfassen:
- Jede Rekursion kann auch mithilfe von Iterationen implementiert werden.
- Rekursion ist keine clevere Implementierung, sondern eine induktive Definition.
- Rekursionslösungen sind häufig kurz und elegant.
- Ob ein Algorithmus schnell oder langsam ist, ist nicht abhängig von Rekursion oder Iteration, es ist abhängig von der Struktur des Problems und der Art und Weise, wie der Algorithmus dammit umgeht.
- Wer Rekursion verwendet muss unbedingt an die Rekursionsbremse denken, ganz analog zur Abbruchbedingung einer Schleife. Andernfalls terminiert die Rekursion nicht - sie bricht lediglich ab, weil der Aufrufstack zu groß wird.
Insbesondere das Fibonacci-Beispiel zeigt, dass eine rekursive Lösung zwar korrekt und leicht formuliert sein kann, ihr Laufzeitverhalten aber eventuell auch problematisch ist - ein Aspekt, dem wir uns in den nächsten Kapitel systematisch widmen.
Hinweis: Eine Denk- und Prüfhilfe zu Rekursionen finden Sie im Anhang.