Kapitel 11: Hashing
Wie haben uns jetzt eine ganze Zeit mit Bäumen und deren Ordnung befasst (sortieren, suchen). Jetzt untersuchen wir eine Datenstruktur, die ein Finden ohne Sortieren erlaubt. Das ist das sogenannte Hashing.
Beim Hashing verwenden wir eine Funktion, welche die Objekte auf eine natürliche Zahl abbildet.
$$f:Objekte \rightarrow \mathbb{N}$$Diese natürliche Zahl steht für den Speicherort des Objekts. Funktion $f$ angewendet auf Objekt $x$ liefert eine positive Ganze Zahl, die Adresse, an der $x$ abgelegt bzw. gefunden werden kann.
Stellen Sie sich ein Array mit $N$ Speicherplätzen vor. Die sind von $0$ bis $N-1$ durchnummeriert. Darin wollen Sie beispielsweise Namen speichern. Dann könnte eine einfache Funktion, welche die Adresse im Array bestimmt, wo ein Name abgelegt wird, wie folgt aussehen. $s$ sei die Zeichenkettendarstellung eines Objekts $x$ (s = str(x)).
Wir addieren die Codierung der einzelnen Zeichen und teilen die Summe ganzzahlig mit Rest durch $N$. Die Modulo-Operation stellt sicher, als Indexwert für die Speicherung eines Namens, einen Wert im Intervall $[0, N-1]$ zu erhalten, einer gültigen Index-Adresse im Array. – Eine solche Funktion heißt Hash-Funktion. Der Preis für die dadurch gewonnene Geschwindigkeit ist, dass wir mit Kollisionen umgehen müssen - schauen wir uns gleich an.
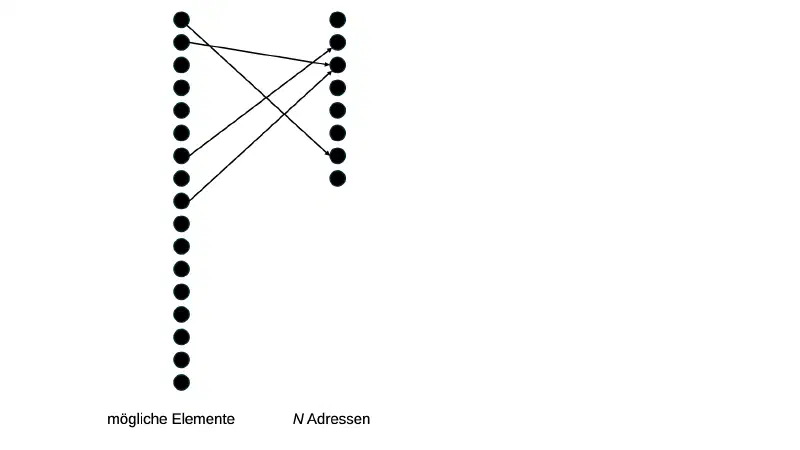
Üblicherweise wird es mehrere Einträge (hier Namen) geben, für die die Hash-Funktion denselben Index berechnet. Werden für verschiedene Objekte gleiche Adressen bestimmt, dann kollidieren sie. Wir nennen das dann jeweils eine Kollision.
Problem: Anzahl der möglichen Elemente ist größer als die Anzahl der Adressen.
Eine Hash-Funktion, auch als Streuwertfunktion bezeichnet, ist eine Abbildung, die eine große Eingabemenge, die Schlüssel, auf eine kleinere Zielmenge, die Hashwerte, abbildet. Eine Hash-Funktion ist daher im Allgemeinen nicht injektiv. Aus den Hashwerten lassen sich die ursprünglichen Werte nicht rekonstruieren.
Die Hash- oder Streuwerte sind meist skalare Werte aus einer begrenzten Teilmenge der natürlichen Zahlen. Eine gute Hash-Funktion liefert dabei für die Eingabedaten Werte derart, dass zwei unterschiedliche Eingaben auch zu unterschiedlichen Ausgabewerten führen. Wir sprechen dann von einer perfekten Hash-Funktion.
In der Regel kennen wir die Eingabedaten jedoch nicht, sodass wir keine perfekte Hash-Funktion konstruieren können. Wir müssen also eine Strategie finden, mit Kollisionen umzugehen. Eine Kollision liegt vor, wenn für zwei ungleiche Objekte $x$ und $y$ $f(x) = f(y)$ gilt.
Die beiden Strategien, mit denen Kollisionen begegnet wird, sind das offene und geschlossene Hashing.
Zum Speichern mittels Hashing werden sogenannte Hash-Tabellen verwendet. Eine grundlegende Eigenschaft dieser Tabellen ist es, sich wie Mengen zu verhalten, also keine Mehrfachspeicherung eines Datenwertes zuzulassen.
Merke: Eine Hash-Tabelle kann man als Verwandte einer Menge auffassen. Deshalb ähneln sich die Operationen (z. B. einfügen, suchen, löschen) – die Hash-Tabelle benötigt beim Einfügen jedoch zusätzlich einen Wert, weil sie im Gegensatz zur Menge nicht nur Elemente speichert. Eine Hash-Tabelle speichert Schlüssel-Wert-Paare.
 1package adt;
 2
 3/**
 4 * Schnittstelle für Hash-Tabellen-Operationen.
 5 *
 6 * @param <V> Datentyp der gespeicherten Werte
 7 */
 8public interface HashTable<K, V> {
 9    /**
10     * Prüft, ob Hash-Tabelle leer ist.
11     *
12     * @return {@code true}, wenn leer, sonst {@code false}
13     */
14    boolean empty();
15    /**
16     * Sucht Wert mit Schlüssel {@code key} in Hash-Tabelle.
17     * @param key gesuchtes Element
18     * @return {@code value}, wenn gefunden, sonst {@code null}
19     */
20    V lookup(K key);
21    /**
22     * {@code value} mit Schlüssel {@code key} einfügen, wenn
23     * Schlüssel noch nicht vorhanden.
24     *
25     * @param key Schlüssel
26     * @param value einzufügendes Element
27     * @return {@code true}, wenn erfolgreich, sonst {@code false}
28     */
29    boolean insert(K key, V value);
30    /**
31     * {@code key} aus Hash-Tabelle löschen.
32     *
33     * @param key Schlüssel des zu löschenden Elements
34     * @return {@code true} bei Erfolg, sonst {@code false}
35     */
36    boolean delete(K key);
37}
Listing 11.1: adt.HashTable.java
Das Interface einer Hash-Tabelle ist daher dem Interface, aufgrund seiner Verwandtschaft, einer Menge sehr ähnlich. Die Operationen haben dieselbe Semantik.
Offenes Hashing
Beim offenen Hashing verwendet man im Allgemeinen ein Array, dessen Indizes die Hashwerte repräsentieren. Jedem Array-Element ist eine Liste zugewiesen. In der Liste eines Array-Elements $i$ werden die Werte gespeichert, die jeweils $i$ als Hashwert haben. Bereits vorhandene Werte werden kein zweites Mal gespeichert.
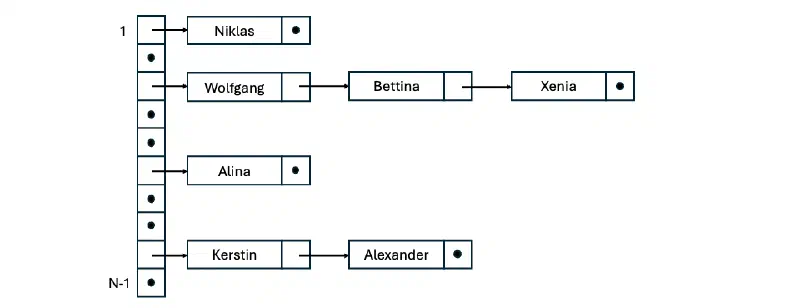
Zu Beginn sind alle Listen im Array [a] der Hash-Tabelle leer. Werden nun Einträge hinzugefügt, wird für jeden neuen Eintrag der zugehörige Indexwert, der Hash-Wert, mithilfe der Hash-Funktion berechnet. Hat dieser Hash-Wert den Wert $i$, wird der neue Eintrag an die Liste a[i] angefügt. Aufgrund der Mengeneigenschaft einer Hash-Tabelle ist zu prüfen, ob es nicht bereits ein wertgleiches Element in dieser Liste gibt. Wenn ja, wird das Einfügen des neuen Elements abgelehnt. Andernfalls wird es der Liste a[i] hinzugefügt.
Zum Suchen eines Elements in der Hash-Tabelle wird dessen Schlüssel verwendet. Wir errechnen dessen Hash-Wert und erhalten damit den Index der Liste, in welcher der Wert sich befinden muss, wenn er in der Hash-Tabelle gespeichert ist. Wir durchsuchen dann die entsprechende Liste.
  1package adt;
  2
  3/**
  4 * Hash-Tabelle für ein offenes Hashing.
  5 * <p>
  6 * <strong>Hinweis</strong>: Der Datentyp {@code K} muss hashable sein, also
  7 *                           {@code equals} und {@code hashCode} implementieren.
  8 */
  9public class OpenHashTable<K, V> implements HashTable<K, V> {
 10    private SingleLinkedList<HashNode<K, V>>[] hashtable;
 11    private int capacity;  // maximale Anzahl der Array-Elemente
 12    private int count;     // Anzahl der Elemente in der Hash-Tabelle
 13
 14    // privates Speicherelement
 15    private static  class HashNode<K, V> {
 16        private K key;     // Schlüssel
 17        private V value;   // Wert
 18
 19        // Konstruktor
 20        private HashNode(K key, V value) {
 21            this.key = key;
 22            this.value = value;
 23        }
 24
 25
 26        // liefert Schlüssel
 27        private K getKey() {
 28            return key;
 29        }
 30
 31
 32        // liefert Wert
 33        private V getValue() {
 34            return value;
 35        }
 36    }
 37
 38
 39    /**
 40     * Konstruktor für offene Hash-Tabelle.
 41     *
 42     * @param N Kapazität/Größe des zu verwendenden Arrays
 43     * @throws IllegalArgumentException wenn die Kapazität kleiner 1 ist
 44     */
 45    @SuppressWarnings("unchecked")
 46    public OpenHashTable(int N) {
 47        if (N < 1)
 48            throw new IllegalArgumentException(
 49                "Kapazität mindestens 1.");
 50        capacity = N;
 51        count = 0;
 52        hashtable = new SingleLinkedList[N];
 53        for (int i = 0; i < N; i++)
 54            hashtable[i] = new SingleLinkedList<>();
 55    }
 56
 57
 58    // Hash-Funktion, nutzt die Java-interne Methode hashCode()
 59    private int hash(K key) {
 60        int h = key.hashCode();
 61        if (h < 0) {
 62            // bei Integer.MIN_VALUE ist Negation ebenfalls negativ,
 63            // weil abs(Integer.MIN_VALUE) < Integer.MAX_VALUE
 64            if (h == Integer.MIN_VALUE) h = 0;
 65            else                        h = -h;
 66        }
 67        return h % capacity;
 68    }
 69
 70
 71    /**
 72     * Prüft, ob Hash-Tabelle leer ist.
 73     *
 74     * @return {@code true}, wenn leer, sonst {@code false}
 75     */
 76    @Override
 77    public boolean empty() {
 78        return count == 0;
 79    }
 80
 81
 82    /**
 83     * Gibt die Anzahl der aktuell verwalteten Element zurück.
 84     *
 85     * @return Anzahl verwalteter Elemente
 86     */
 87    public int count() {
 88        return count;
 89    }
 90
 91
 92    /**
 93     * Sucht Wert mit Schlüssel {@code key} in Has-Tabelle.
 94     * @param key gesuchtes Element; @{code null} wenn nicht gefunden
 95     * @return {@code value}, wenn gefunden, sonst {@code null}
 96     * @throws IllegalArgumentException wenn Schlüssel gleich null
 97     */
 98    @Override
 99    public V lookup(K key) {
100        if (key == null)
101            throw new IllegalArgumentException(
102                "Schlüssel darf nicht null sein.");
103        int index = hash(key);
104        if (hashtable[index].empty())
105            // Liste ist leer, nichts gefunden
106            return null;
107        else {
108            // Liste ist nicht leer -> Schlüssel suchen
109            HashNode<K, V> x;
110            EnumList<HashNode<K, V>> e = new EnumList<>(hashtable[index]);
111            while (e.hasMoreElements()) {
112                x = (e.nextElement());
113                if (key.equals(x.getKey()))
114                    return x.getValue();  // gefunden
115            }
116        }
117        // Liste durchsucht und nichts gefunden
118        return null;
119    }
120
121
122    /**
123     * {@code value} mit Schlüssel {@code key} einfügen, wenn
124     * Schlüssel noch nicht vorhanden.
125     *
126     * @param key Schlüssel
127     * @param value einzufügendes Element
128     * @return {@code true}, wenn erfolgreich, sonst {@code false}
129     * @throws IllegalArgumentException wenn Schlüssel gleich null
130     */
131    @Override
132    public boolean insert(K key, V value) {
133        if (key == null)
134            throw new IllegalArgumentException(
135                "Schlüssel darf nicht null sein.");
136        int index = hash(key);
137        HashNode<K, V> node = new HashNode<>(key, value);
138
139        // prüfe auf eventuelle Kollisionen
140        if (hashtable[index].empty()) {
141            // Liste ist noch leeren
142            // -> direkt einfügen
143            hashtable[index].insert(node);
144            count++;
145            return true;  // Erfolg
146        } else {
147            // Liste ist nicht leer
148            // -> prüfe, ob Wert bereits vorhanden
149            HashNode<K, V> x;
150            EnumList<HashNode<K, V>>e = new EnumList<>(hashtable[index]);
151            while (e.hasMoreElements()) {
152                x = (e.nextElement());
153                if (key.equals(x.getKey()))
154                    // Kollision und Wert vorhanden
155                    // -> Element ablehnen
156                    return false;  // kein Erfolg
157            }
158        }
159
160        // Kollision, jedoch Wert noch nicht vorhanden
161        // -> einfügen
162        hashtable[index].insert(node);
163        count++;
164        return true;  // Erfolg
165    }
166
167
168    /**
169     * {@code key} aus Hash-Tabelle löschen.
170     *
171     * @param key Schlüssel des zu löschenden Elements
172     * @return {@code true} bei Erfolg, sonst {@code false}
173     * @throws IllegalArgumentException wenn Schlüssel gleich null
174     */
175    @Override
176    public boolean delete(K key) {
177        if (key == null)
178            throw new IllegalArgumentException(
179                "Schlüssel darf nicht null sein.");
180        int index = hash(key);
181
182        if (hashtable[index].empty())
183            // Liste leer -> sicher, dass Element nicht vorhanden
184            //            -> kann also auch nicht gelöscht werden
185            return false;  // kein Erfolg
186        else {
187            // Liste nicht leer -> durchsuchen
188            hashtable[index].reset();
189            while (!hashtable[index].endpos()) {
190                if (key.equals((hashtable[index].content()).getKey())) {
191                    // Schlüssel gefunden -> löschen (Erfolg)
192                    hashtable[index].delete();
193                    count--;
194                    return true;
195                }
196                hashtable[index].forward();
197            }
198        }
199        // Schlüssel nicht gefunden: kein Erfolg
200        return false;
201    }
202}
Listing 11.2: adt.OpenHashTable.java
Die Effizienz des offenen Hashings ist stark von der Größe des Arrays und den davon abhängigen Längen der jeweiligen Listen beeinflusst. Je kürzer die Listen, umso effizienter sind die Operationen auszuführen.
Geschlossenes Hashing
Beim geschlossenen Hashing werden alle Datenwerte direkt in einem Array abgelegt. Bei den meisten Programmiersprachen sind Arrays nicht dynamisch, sodass der benötigte Speicherplatz zu Beginn alloziert werden muss.
Falls $y = f(x)$ schon belegt ist, so wird bei geschlossenen Hashing, im Falle einer Kollision, systematisch ein alternativer Speicherplatz gesucht.
Dabei unterscheiden wir verschiedene Strategien, sogenannte Sondierungsstrategien.
- $y+1, y+2, y+3, y+4, \dots$ - lineares Sondieren
- $y+1, y+4, y+9, y+16, \dots$ - quadratisches Sondieren
- $y +f_2(x), y + 2\cdot f_2(x), \dots$ - Double Hashing mit zweiter Hash-Funktion; Schrittweite wird durch zweite Hash-Funktion bestimmt
Alle Berechnungen werden jeweils Modulo $N$ durchgeführt. Insgesamt werden höchstens $N-1$ Sondierschritte verursacht. Beim quadratischen Sondieren werden gegebenenfalls nicht alle Array-Elemente besucht. Das vermeidet Clusterbildung, die beim linearen Sondieren auftreten kann.
In jedem Array-Element werden drei Dinge gespeichert. Der Schlüssel, der eigentliche Datenwert und der Status des Array-Elements (leer, belegt, gelöscht). Die drei Status sind erforderlich, um beim Suchen eines alternativen Speicherplatzes bei Kollisionen den nächsten freien Platz im Array zu finden. Gelöschte Werte werden nicht entfernt, sondern als gelöscht markiert.
Beispiel: Nehmen wir an, wir wollen Susi und Sören in die Hash-Tabelle einfügen. Beide haben denselben Hash-Wert und Susi steht bereits in der Tabelle. Den gleichen Speicherplatz dürfen sie nicht belegen. Daher ist für Sören ein neuer Platz zu finden. Wir nutzen als Sondierungsstrategie das lineare sondieren.
- Fall: Das nächste Array-Element ist als leer gekennzeichnet. Dann speichern wir Sören an dieser Stelle.
- Fall: Auch das nächste Array-Element ist belegt. Dann suchen wir weiter, bis ein Speicherplatz leer oder als gelöscht markiert ist.
Beim Suchen müssen wir etwas beharrlicher sein. Finden wir den gesuchten Schlüssel nicht direkt an der Index-Position seines Hash-Wertes, kann er nachfolgend gespeichert sein. Die Suche kann enden, wenn wir auf ein als leer gekennzeichnetes Array-Element treffen. Alle als gelöscht oder belegt gekennzeichneten Elemente stellen jedoch potenzielle Fundorte dar und sind bei der Suche zu berücksichtigen.
Fazit: Wir benötigen drei Status. Das sind „frei", „belegt" und „gelöscht".
Beim Suchen kann es passieren, dass wir „überdrehen". Das Array ist analog einem Ringpuffer (RingBuffer.java) aufgebaut. Wir brauchen also einen Wächter, der verhindert, dass wir ständig im Kreis suchen, wenn das Array entsprechend besetzt ist und wir nichts gefunden haben.
  1package adt;
  2
  3import java.lang.reflect.Array;
  4
  5/**
  6 * Hash-Tabelle für ein geschlossenes Hashing.
  7 * <p>
  8 * <strong>Hinweis</strong>: Der Datentyp {@code K} muss hashable sein, also
  9 *                           {@code equals} und {@code hashCode} implementieren.
 10 */
 11public class ClosedHashTable<K, V> implements HashTable<K, V> {
 12
 13    // privates Speicherelement
 14    private static class HashNode<K, V> {
 15        private K key;      // Schlüssel
 16        private V value;    // Wert
 17        private char state; // E = Empty, D = Deleted, O = Occupied
 18
 19        // Konstruktor - zu Beginn ist Element leer
 20        private HashNode(K key, V value) {
 21            this.key = key;
 22            this.value = value;
 23            this.state = 'E';
 24        }
 25
 26
 27        // Schlüssel liefern
 28        private K getKey() {
 29            return key;
 30        }
 31
 32
 33        // Schlüssel setzen
 34        private void setKey(K key) {
 35            this.key = key;
 36        }
 37
 38
 39        // Wert liefern
 40        private V getValue() {
 41            return value;
 42        }
 43
 44
 45        // Wert setzen
 46        private void setValue(V value) {
 47            this.value = value;
 48        }
 49
 50
 51        // Status liefern
 52        private char getState() {
 53            return state;
 54        }
 55
 56
 57        // Status setzen
 58        private void setState(char state) {
 59            this.state = state;
 60        }
 61    }
 62
 63    // Achtung: Wir benutzen Object[]
 64    //
 65    // Java gestattet es nicht ein Array auf Basis einer generischen
 66    // Typangabe T[] zu erzeugen!
 67    private Object[] hashtable;  // Array als interner Speicher
 68
 69    private int capacity;        // maximale Anzahl Tabellenelemente
 70    private int count;           // Anzahl der Tabellenelemente
 71
 72    /**
 73     * Konstruktor für die Hash-Tabelle.
 74     *
 75     * Jedes Array-Element wird mit einem leeren Node initialisiert.
 76     *
 77     * @param N Kapazität/Größe des Arrays
 78     * @throws IllegalArgumentException wenn Größe nicht mindestens 1
 79     */
 80    public ClosedHashTable(int N) {
 81        if (N < 1)
 82            throw new IllegalArgumentException(
 83                "Kapazität mindestens 1.");
 84        capacity = N;
 85        count = 0;
 86        hashtable = new Object[N];
 87        for (int i = 0; i < N; i++) {
 88            hashtable[i] = new HashNode<K, V>(null, null);
 89        }
 90    }
 91
 92
 93    // Hash-Funktion, nutzt die Java-interne Methode hashCode()
 94    private int hash(K key) {
 95        int h = key.hashCode();
 96        if (h < 0) {
 97            // bei Integer.MIN_VALUE ist Negation ebenfalls negativ,
 98            // weil abs(Integer.MIN_VALUE) < Integer.MAX_VALUE
 99            if (h == Integer.MIN_VALUE)
100                h = 0;
101            else
102                h = -h;
103        }
104        return h % capacity;
105    }
106
107
108    /**
109     * Prüft, ob Hash-Tabelle leer ist.
110     *
111     * @return {@code true}, wenn leer, sonst {@code false}
112     */
113    @Override
114    public boolean empty() {
115        return count == 0;
116    }
117
118
119    /**
120     * Gibt die Anzahl der aktuell verwalteten Element zurück.
121     *
122     * @return Anzahl verwalteter Elemente
123     */
124    public int count() {
125        return count;
126    }
127
128
129    /**
130     * Prüft, ob Hash-Tabelle voll ist.
131     *
132     * @return {@code true}, wenn Tabelle voll, sonst {@code false}
133     */
134    public boolean full() { return count == capacity; }
135
136
137    /**
138     * Rückgabe der Kapazität.
139     *
140     * @return Kapazität
141     */
142    public int capacity() { return capacity; }
143
144
145    /**
146     * Sucht Wert mit Schlüssel {@code key} in Hash-Tabelle.
147     *
148     * @param key gesuchtes Element; {@code null} wenn nicht gefunden
149     * @return {@code value}, wenn gefunden, sonst {@code null}
150     * @throws IllegalArgumentException wenn Schlüssel gleich null
151     */
152    @SuppressWarnings("unchecked")
153    @Override
154    public V lookup(K key) {
155        if (key == null)
156            throw new IllegalArgumentException(
157                "Schlüssel darf nicht null sein.");
158
159        if (empty())
160            // Hash-Tabelle leer, es gibt nichts zu finden
161            return null; // kein Erfolg
162
163        int sentinel = hash(key);  // Wächter für "Überdrehen"
164        int index = sentinel;
165
166        // solange Status belegt oder gelöscht suchen
167        HashNode<K,V> node = (HashNode<K,V>) hashtable[index];
168        while (node.getState() == 'O' || node.getState() == 'D') {
169            // wenn Schlüssel in einem belegten Feld gefunden -> liefern
170            if (((HashNode<K, V>) hashtable[index]).getState() == 'O' &&
171                    key.equals(((HashNode<K, V>) hashtable[index]).getKey())) {
172                return ((HashNode<K, V>) hashtable[index]).getValue();
173            }
174            // // weiter im Array voranschreiten
175            index = (index + 1) % capacity;
176            // wenn Wächter erreicht -> nichts gefunden
177            if (index == sentinel)
178                return null; // überdreht
179        }
180        // nichts in der Nachbarschaft des Hash-Wertes gefunden
181        return null;
182    }
183
184
185    /**
186     * {@code value} mit Schlüssel {@code key} einfügen, wenn
187     * Schlüssel noch nicht vorhanden.
188     *
189     * @param key Schlüssel
190     * @param value einzufügendes Element
191     * @return {@code true}, wenn erfolgreich, sonst {@code false}
192     * @throws IllegalArgumentException wenn Schlüssel gleich null
193     */
194    @SuppressWarnings("unchecked")
195    public boolean insert(K key, V value) {
196        if (key == null)
197            throw new IllegalArgumentException(
198                "Schlüssel darf nicht null sein.");
199
200        // wenn Array voll, kann nichts mehr eingefügt werden
201        if (full())
202            return false;
203
204        int sentinel = hash(key);  // Wächter für "Überdrehen"
205        int index = sentinel;
206        int firstDeleted = -1;     // merke gelöschte Elemente
207
208        while (true) {
209            HashNode<K, V> node = (HashNode<K, V>) hashtable[index];
210            char state = node.getState();
211
212            if (state == 'E') {
213                // Ende der Probe-Sequenz: hier einfügen
214                if (firstDeleted != -1)
215                    index = firstDeleted;
216                node = (HashNode<K, V>) hashtable[index];
217                node.setKey(key);
218                node.setValue(value);
219                node.setState('O');
220                count++;
221                return true;
222            }
223
224            if (state == 'O') {
225                if (key.equals(node.getKey()))
226                    return false; // Key existiert schon
227            } else { // state == 'D'
228                // ersten Tombstone merken, aber weiter suchen
229                // (Key könnte später kommen!)
230                if (firstDeleted == -1)
231                    firstDeleted = index;
232            }
233
234            index = (index + 1) % capacity;
235            if (index == sentinel) {
236                // Umlauf: nur möglich, wenn kein 'E' mehr existiert
237                if (firstDeleted != -1) {
238                    HashNode<K, V> d = (HashNode<K, V>)
239                                           hashtable[firstDeleted];
240                    d.setKey(key);
241                    d.setValue(value);
242                    d.setState('O');
243                    count++;
244                    return true;
245                }
246                return false;
247            }
248        }
249    }
250
251
252    /**
253     * Rückgabe eines Arrays mit den in der Tabelle gespeicherten Werten.
254     *
255     * @param type Datentyp der Werte (z.B.: String.class)
256     * @return Array mit Werten der Hash-Tabelle
257     * @throws IllegalArgumentException wenn Typangabe null
258     */
259    @SuppressWarnings("unchecked")
260    public V[] getValues(Class<V> type) {
261        if (type == null)
262            throw new IllegalArgumentException(
263                "Datentyp darf nicht null sein.");
264        V[] values = (V[]) Array.newInstance(type, count);
265        int j = 0;
266        for (int i = 0; i < capacity; i++) {
267            if (((HashNode<K, V>) hashtable[i]).getState() == 'O')
268                values[j++] = ((HashNode<K, V>) hashtable[i]).getValue();
269        }
270        return values;
271    }
272
273
274    /**
275     * {@code key} aus Hash-Tabelle löschen.
276     *
277     * @param key Schlüssel des zu löschenden Elements
278     * @return {@code true} bei Erfolg, sonst {@code false}
279     * @throws IllegalArgumentException wenn Schlüssel gleich null
280     */
281    @SuppressWarnings("unchecked")
282    public boolean delete(K key) {
283        if (key == null)
284            throw new IllegalArgumentException(
285                "Schlüssel darf nicht null sein.");
286        if (empty())
287            return false;
288
289        int sentinel = hash(key);  // Wächter
290        int index = sentinel;
291
292        HashNode<K,V> node = (HashNode<K,V>) hashtable[index];
293        while (node.getState() == 'O' || node.getState() == 'D') {
294            if (node.getState() == 'O' && key.equals(node.getKey())) {
295                node.setState('D');
296                count--;
297                return true;
298            }
299
300            index = (index + 1) % capacity;
301            if (index == sentinel)
302                return false;
303        }
304        return false;
305    }
306}
Listing 11.3: adt.ClosedHashTable.java
Fallstudie: Wörterbuchsuche mit Hash-Tabelle
Versuchen Sie das folgende Programm HashTableDict.java zuerst selbst zu implementieren. Es liest, ganz analog zu RangeAutocomplete.java, eine Wörterbuchdatei ein. Das Programm soll, nach dem Einlesen der Datei, eine Benutzerschnittstelle zum Suchen von Worten, anbieten. Mit dem Kommando quit verlässt der Benutzer das Programm.
Folgende Überlegungen sollten Sie anstellen:
- Welche Art von Wortsuche ist mithilfe einer Hash-Tabelle sinnvoll durchzuführen?
- Welchen Einfluss hat es auf die Ladezeit, ob eine Wörterbuchdatei sortiert ist oder nicht?
Begründen Sie das Ergebnis Ihrer Überlegungen.
  1import java.io.FileInputStream;
  2
  3import adt.HashTable;
  4import adt.ClosedHashTable;
  5import de.pakad.udemy.StdErr;
  6import de.pakad.udemy.StdIn;
  7import de.pakad.udemy.StdOut;
  8
  9
 10/**
 11 * Wörterbuch-Modellierung mithilfe einer Hash-Tabelle (geschlossenes Hashing).
 12 */
 13public class HashTableDict {
 14
 15    // Ein Wort zum Suchbaum hinzufügen
 16    private static void addWord(HashTable<String, WordInfo> table,
 17                                                  String w,
 18                                                  int lineNo) {
 19        if (!w.isEmpty()) {
 20            WordInfo wordinfo = new WordInfo(w);
 21            wordinfo.seenInLine(lineNo);
 22            table.insert(w, wordinfo);
 23        }
 24    }
 25
 26
 27    // HashTable aufbauen
 28    private static HashTable<String, WordInfo> buildIndexFromStdIn(int size) {
 29        HashTable<String, WordInfo> table = new ClosedHashTable<>(size);
 30        int lineNo = 0;  // wird für WordInfo gebraucht, ist hier aber nutzlos
 31        while (StdIn.hasNextLine()) {
 32            String line = StdIn.readLine();
 33            if (line == null) break;
 34            lineNo++;
 35
 36            StringBuilder word = new StringBuilder();
 37            for (int i = 0; i < line.length(); i++) {
 38                char ch = line.charAt(i);
 39                if (Character.isLetterOrDigit(ch)) {
 40                    word.append(ch);
 41                } else {
 42                    if (!word.isEmpty()) {
 43                        addWord(table, word.toString(), lineNo);
 44                        word.setLength(0);
 45                    }
 46                }
 47            }
 48            if (!word.isEmpty()) {
 49                addWord(table, word.toString(), lineNo);
 50            }
 51        }
 52        return table;
 53    }
 54
 55
 56    // Wort-Suche
 57    private static void queryWord(HashTable<String, WordInfo> table,
 58                                  String word) {
 59        WordInfo wordinfo = table.lookup(word);
 60        if (wordinfo == null)
 61            StdOut.printf("%s nicht gefunden%n", word);
 62        else
 63            StdOut.printf("%s gefunden%n", word);
 64    }
 65
 66
 67    // Kommando-Interface
 68    private static void commandLoop(HashTable<String, WordInfo> table) {
 69
 70        while (true) {
 71            StdOut.println("Befehle: search <word> | quit");
 72            StdOut.print("> ");                 // <<< PROMPT
 73            if (!StdIn.hasNextLine()) return;   // EOF -> Ende
 74
 75            String[] parts = StdIn.readlnStrings();
 76            if (parts.length == 0 || parts[0].isEmpty()) continue;
 77
 78            String cmd = parts[0].toLowerCase();
 79
 80            switch (cmd) {
 81                case "quit" -> {
 82                    StdOut.println("Ende.");
 83                    return;
 84                }
 85                case "search" -> {
 86                    if (parts.length < 2)
 87                        StdOut.println("Fehler: search <word>");
 88                    else
 89                        queryWord(table, parts[1]);
 90                }
 91                default -> StdOut.println("Unbekannter Befehl.");
 92            }
 93        }
 94    }
 95
 96
 97    /**
 98     * Hauptprogramm. HashTable-Suche in einem Wörterbuch nachdem eine Datei eingelesen
 99     * wurde.
100     * <p>
101     * Operationen: exakte Wortsuche
102     * </p>
103     * @param args <br>
104     * [0] - Größe der Hash-Tabelle<br>
105     * [1] - Dateiname
106     */
107    public static void main(String[] args) {
108        int size = 0;  /// Größe der Hash-Tabelle
109
110        // Programmaufruf prüfen
111        if (args.length < 2) {
112            StdOut.println(
113                "Usage: java HashTableDict <size> <filename>");
114            return;
115        }
116
117        try {
118            size = Integer.parseInt(args[0]);
119        } catch(Exception e1) {
120            StdErr.println(e1);
121            System.exit(1);  // Fehlerstatus, Programmende
122        }
123
124        // 1 - Textdatei als StdIn-Quelle setzen
125        try (FileInputStream in = new FileInputStream(args[1])) {
126            StdIn.setInputStream(in);
127            HashTable<String, WordInfo> tree = buildIndexFromStdIn(size);
128
129            // 2 - zurück zur Tastatur für interaktive Befehle
130            StdIn.resetToSystemIn();
131
132            StdOut.println("Index aufgebaut. Interaktive Abfragen:");
133            commandLoop(tree);
134        } catch(Exception e2) {
135            StdErr.println(e2);
136            System.exit(1);  // Fehlerstatus, Programmende
137        }
138    }
139}
Listing 11.4: HashTableDict.java
Beobachtung
Bei einer geschlossenen Hash-Tabelle hat eine mögliche Sortierung der Eingabedaten keinen Einfluss auf die Ladezeit. Ebenso ist die Laufzeit zum Finden eines gesuchten Elements unabhängig von der Anzahl der gespeicherten Elemente. Dank der Hash-Funktion finden wir stets direkt den entsprechenden Speicherplatz. Lediglich Kollisionen können dazu führen, dass der Aufwand für das Suchen sich erhöht. Die Anzahl möglicher Kollisionen hängt im Wesentlichen von der Größe des gewählten Arrays ab. Je größer das Array der Hash-Tabelle ist, umso geringer ist die Wahrscheinlichkeit einer Kollision. - In jedem Fall muss beim geschlossenen Hashing hinreichend Platz in der Tabelle sein, um alle Einträge aufnehmen zu können.
Laufzeit beim geschlossenen Hashing
Die folgende Laufzeitbetrachtung erfolgt ohne direkten Nachweis. Sie können Sie jedoch in jedem guten Informatik-Buch zum Thema Hashing nachlesen.
Sei $n$ die Anzahl der in der Hash-Tabelle zur Zeit gespeicherten Objekte und $N$ die Anzahl der möglichen Speicherpositionen.
Sei ferner $\alpha = \frac{n}{N} < 1$ der Auslastungsgrad.
Dann ergibt sich für die Anzahl der Schritte mit Double-Hashing als Kollisionsstrategie bei
- erfolgloser Suche: $\approx \frac{1}{1 - \alpha} = 5.0$ für $\alpha = 0.8$
- erfolgreicher Suche: $\approx -\frac{\ln(1 - \alpha)}{\alpha} = 2.01$ für $\alpha=0.8$
Das heißt, in durchschnittlich $2$ Schritten wird bei einem Auslastungsgrad von $0.8$, in einer Hash-Tabelle der Größe $1.25$ Millionen mit $1$ Million Elementen, das richtige Objekt gefunden. Ein AVL-Baum, eine optimierte Version unseres Baumes, benötigt dafür etwa $20$ Vergleiche. Dazu kommt, dass der Aufwand in der Hash-Tabelle für einen konkreten Auslastungsgrad jeweils konstant ist. Die Anzahl der Schritte hängt nicht von $n$ ab, sondern vom Auslastungsgrad. Bei $1$ Milliarde Elementen sind, wenn der Auslastungsgrad weiterhin $0.8$ beträgt, auch nur durchschnittlich $2$ Schritte zum Finden eines Objekts erforderlich. Bei Baum wären das etwa 30 Vergleiche.
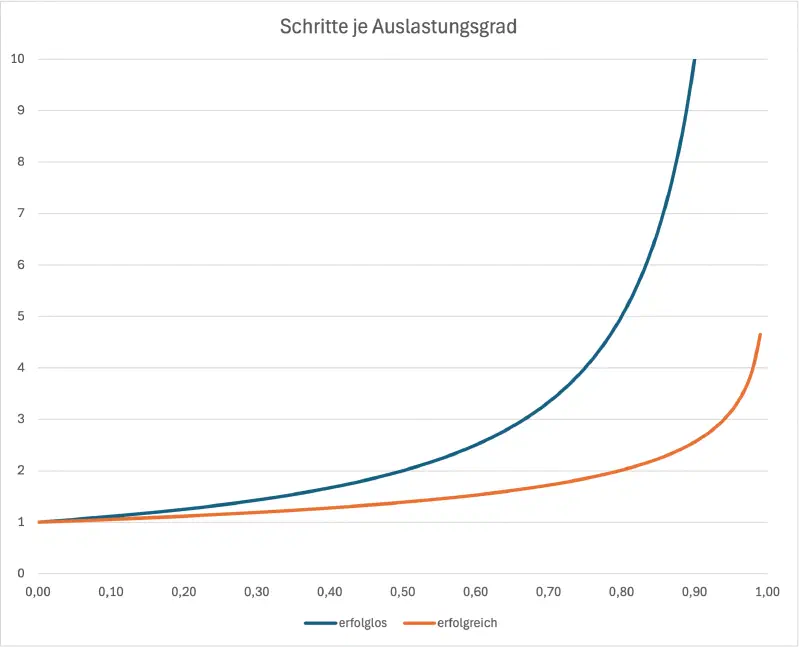
Die y-Achse zeigt die durchschnittliche Anzahl der benötigten Schritte.
Vergleich mit AVL-Bäumen
| AVL-Baum | Geschlossenes Hashing | |
|---|---|---|
| Laufzeit | logarithmisch | konstant |
| Speicherbedarf | dynamisch wachsend | in Sprüngen wachsen |
| Sortierung | möglich durch Traversierung | nicht möglich |
Vergleich AVL-Baum mit geschlossenem Hashing {#tab:Vergleich-AVL-Baum-mit-geschlossenem-Hashing}
Merkbox zum Hashing
Denkfalle: Hashing ist keine Ordnung!
Eine häufige Fehlvorstellung ist, dass eine Hash-Tabelle die gespeicherten Schlüssel „irgendwie sortiert" oder zumindest in einer festen Reihenfolge verwaltet.
Tatsächlich erzeugt die Hash-Funktion keine Ordnung, sondern lediglich eine Abbildung von Schlüsseln auf Speicheradressen. Zwei Schlüssel, die logisch „nah beieinander liegen", können an völlig unterschiedlichen Positionen gespeichert werden – und umgekehrt.
Folgen dieser Denkfalle:
- Iterieren über eine Hash-Tabelle liefert keine wohldefinierte Reihenfolge.
- Operationen wie „kleinstes Element", „nächstgrößerer Schlüssel" oder Bereichsanfragen sind mit Hashing nicht effizient möglich. Für solche Aufgaben sind geordnete Datenstrukturen (z. B. Suchbäume) erforderlich.
Merke: Hashing optimiert das Finden einzelner Elemente, nicht das Arbeiten mit geordneten Mengen.